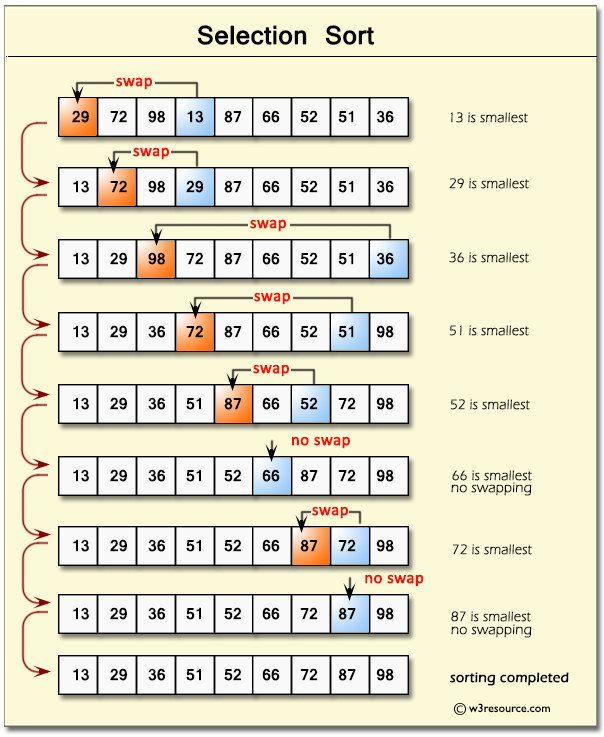
选择排序
每一轮从剩余元素中选出最小的, 放到前面
-
第 1 轮: 在 a[0..n-1] 里找最小, 换到 a[0]
-
第 2 轮: 在 a[1..n-1] 里找最小, 换到 a[1]
-
依此类推, 共 n-1 轮; 第 i 轮结束时 a[0..i] 已经有序
每一轮: 在未排序部分挑出最小的, 与未排序部分的第一个交换
选择排序 · 代码
/* 选择排序 (约定: a[0..n-1] 已读入 n 个元素) */
for (int i = 0; i < n - 1; i++) {
  int min = i;                       /* 先假设 a[i] 最小 */
  for (int j = i + 1; j < n; j++) {  /* 往后找更小的 */
    if (a[j] < a[min]) {
      min = j;
    }
  }
  int t = a[i]; a[i] = a[min]; a[min] = t;  /* 交换 */
}-
一共 n-1 轮, 第 i 轮结束后 a[0..i] 已经有序
后面学了函数, 就能把这整段封装成 sort(a, n) 随时调用
冒泡排序
相邻元素两两比较, 顺序不对就交换
-
第 1 轮: 从头比到尾, 最大的元素一路"沉"到 a[n-1]
-
第 2 轮: 再比一遍, 次大的沉到 a[n-2] (末尾已就位, 少比一个)
-
共 n-1 轮; 每一轮结束, 本轮最大的元素"沉底"
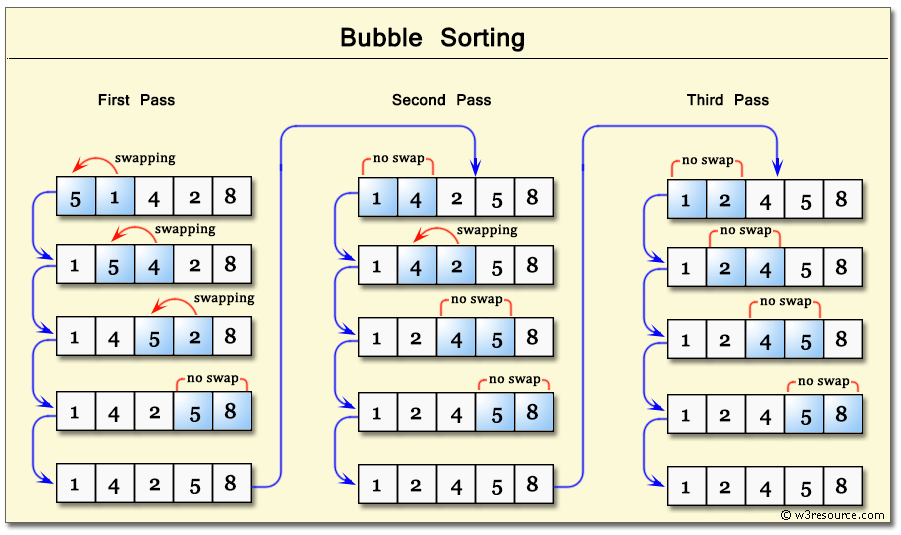
相邻比较、逐个交换, 最大的逐步"沉"到末尾
冒泡排序 · 代码
/* 冒泡排序: 把 a[0..n-1] 从小到大排好 */
for (int i = 0; i < n - 1; i++) {         /* 共 n-1 轮 */
  for (int j = 0; j < n - 1 - i; j++) {   /* 每轮少比一个 */
    if (a[j] > a[j + 1]) {
      int t = a[j];
      a[j] = a[j + 1];
      a[j + 1] = t;
    }
  }
}-
每一轮结束, 本轮未排序部分的最大元素"沉"到最后
-
三种排序里过程最形象的一种——相邻比较、逐轮沉底
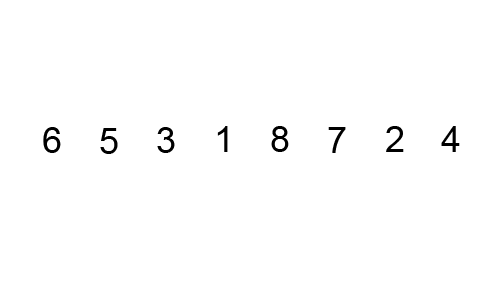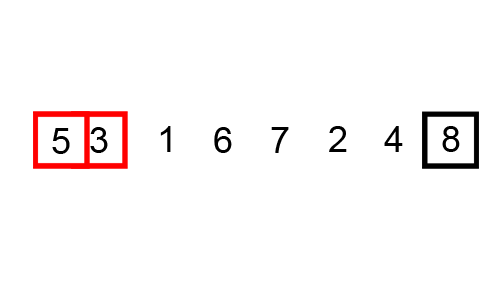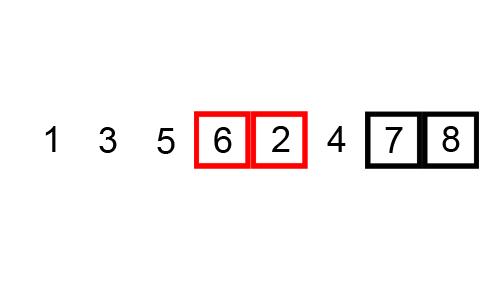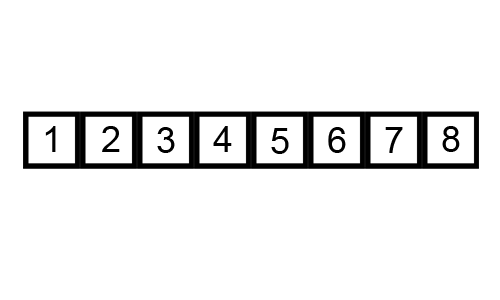
插入排序
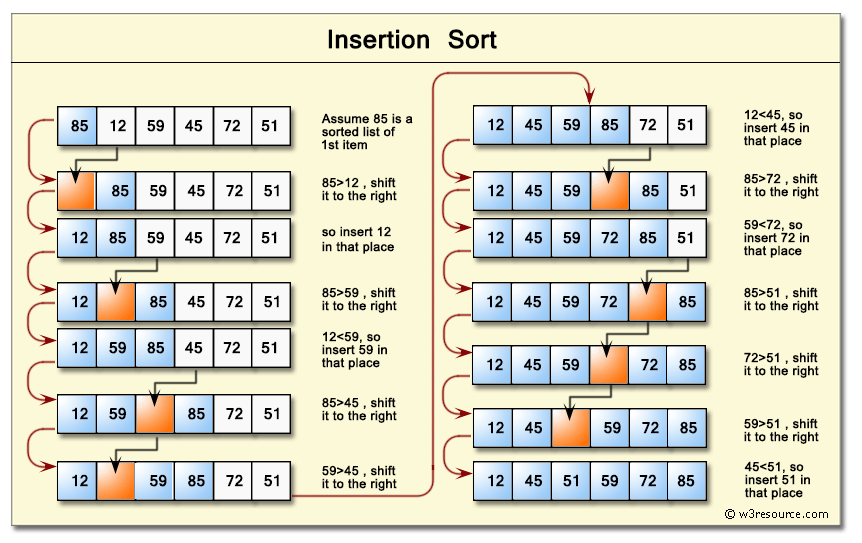
像打牌理手牌: 每次拿起一张, 插到已排序部分的正确位置
-
左手: 已排序的牌, 起初只有 a[0]
-
右手: 每次拿起下一张 key = a[i]
-
从右往左比: 比 key 大的往后挪一格, 找到位置把 key 放进去
已排序部分逐步变长, 每个 key 与前面的元素比较、右移, 再插到正确位置
插入排序 · 代码
/* 插入排序: 把 a[0..n-1] 从小到大排好 */
for (int i = 1; i < n; i++) {
  int key = a[i];                          /* 拿起的"牌" */
  int j;                                   /* 循环后还要用 j */
  for (j = i - 1; j >= 0 && a[j] > key; j--) {  /* 比 key 大的往后挪 */
    a[j + 1] = a[j];
  }
  a[j + 1] = key;                          /* 放进去 */
}-
三种排序都是 O(n²)——数据量不大时完全够用
内层 for 退出时: j 停在第一个 ≤ key 的元素 (或 -1), 位置 a[j+1] 已空出, key 正好放进去。
例: [2, 5] 插 key=4 —— j 从 1 开始: a[1]=5 > 4 → 右移, j 变 0; a[0]=2 ≤ 4 → 停, 退出时 j = 0, 放入 a[1] → [2, 4, 5]
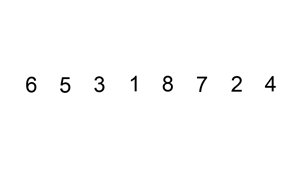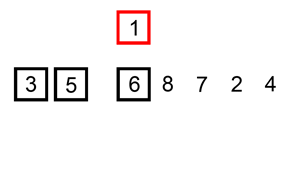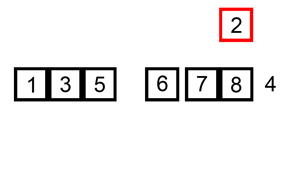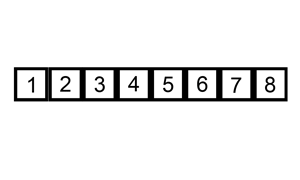
二分查找
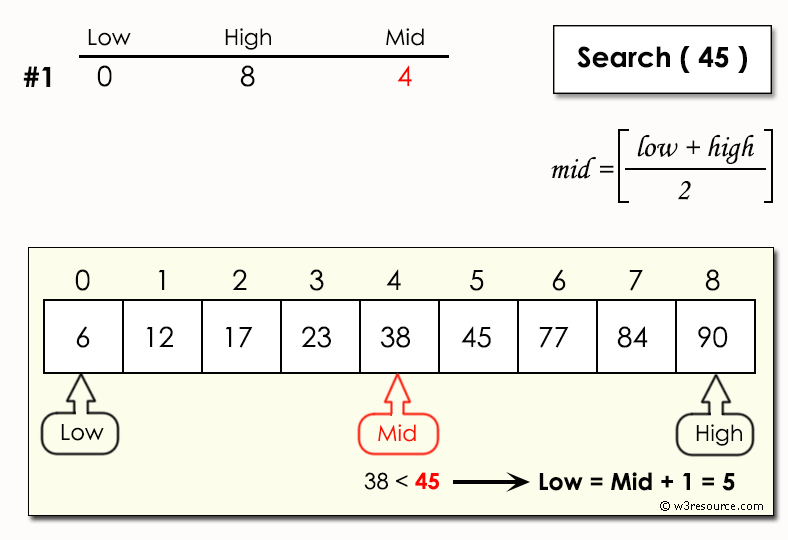
数据排好序后, 可以每次砍掉一半: 和中间元素比较, 决定去左半边还是右半边
每次和中间元素比较, 砍掉不可能的一半
二分查找 · 代码
/* 二分查找: a 必须已从小到大排好序 */
int low = 0, high = n - 1;
while (low <= high) {
  int mid = (low + high) / 2;
  if (a[mid] == key) {
    printf("找到, 下标 %d\n", mid);
    break;
  }
  if (a[mid] < key) {
    low = mid + 1;
  } else {
    high = mid - 1;
  }
}
if (low > high) {
  printf("没找到\n");
}-
n 个元素最多比较 log2(n)+1 次——100 万个数也只要约 20 次!